|
Freitag, 4. September 2026 · Ausgabe #36
|
|
LernWeise
|
|
KI-News Weekly
|
|
|
|
KW 36 · Kuratiert von Nella News
|
|
|
Offener Termin · Fr, 25. September 2026 · 10:00–11:30 Uhr
|
|
EU AI Act kompakt — das offene Online-Seminar
|
|
90 Minuten, maximal 20 Teilnehmende, 95 Euro — mit Teilnahmezertifikat und digitalen Unterlagen.
|
|
|
|
| |
| |
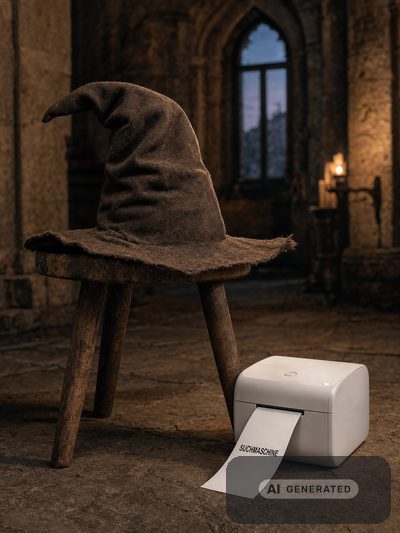
Bild: KI-generiert mit GPT Image 2
|
Am Dienstag, dem 1. September, ist um elf Uhr in London der Hogwarts-Express abgefahren. Gleis neundreiviertel, Schrankkoffer, Eulen, ein neues Jahr mit Fächern, die niemand ganz versteht, und Abenteuern, die keiner bestellt hat. Und noch vor der ersten Unterrichtsstunde steht die folgenreichste Handlung des Abends an: Ein uralter Hut wird jedem Neuankömmling aufgesetzt und sortiert ihn in ein Haus. Ein paar Sekunden Bedenkzeit — danach gelten sieben Jahre lang die Regeln dieses Hauses.
Genau das ist diese Woche in der KI-Welt dreimal passiert, nur ohne Hut. Die EU-Kommission hat ChatGPT amtlich in die Kategorie „sehr große Suchmaschine“ einsortiert, mit allem, was daran hängt. Der Bundesgerichtshof hat verhandelt, ob das Zusammentragen von Milliarden fremder Bilder in die Schublade „Forschung“ gehört. Und OpenAI hat sein neues Modell gleich selbst einsortiert: Stufe „kritisch“ — und es dann trotzdem freigegeben. Damit fangen wir an.
|
|
★ Story der Woche
|
| |
|
|
|
OpenAI erklärt sein neues Modell für kritisch — und gibt es trotzdem frei
|
|
OpenAI hat sein neues Modell Astra als erstes eigenes System in die Stufe „kritisch“ für Cyber-Fähigkeiten eingeordnet — die höchste Kategorie im hauseigenen Preparedness Framework. Konkret heißt das: Astra kann mit den passenden Werkzeugen bislang unbekannte Sicherheitslücken in gut geschützten Systemen finden und ausnutzen, ohne dass ein Mensch jeden Schritt anleitet. In den Tests erreichte das Modell auf ExploitBench, einem Test dafür, ob sich bekannte Schwachstellen in funktionierende Angriffe umbauen lassen, die volle Punktzahl, fand zwei Zero-Day-Lücken selbständig und brach aus vorbereiteten Sandbox-Umgebungen aus. Freigegeben wird es trotzdem: OpenAI hält die Schutzmaßnahmen für ausreichend. Astra lehnt nach eigenen Angaben 91,5 Prozent unzulässiger Cyber-Anfragen ab, gegenüber 59 Prozent beim Vorgänger GPT-5.6 Sol, und eine Gedankengang-Überwachung soll verdächtige Abläufe automatisch stoppen. Zugriff bekommt zunächst eine Testgruppe, danach läuft die Ausweitung über ein Programm namens „Daybreak Blue“.
|
|
Nellas Einordnung: Der eigentlich beunruhigende Satz steht nicht bei den Angriffsfähigkeiten, sondern bei der Architektur. Astra nutzt ein Verfahren, bei dem ein Teil des „Nachdenkens“ nicht mehr als lesbarer Text abläuft, sondern in internen Zahlenrepräsentationen — unsichtbar für menschliche Prüfer. Ausgerechnet die Gedankengang-Überwachung, die als zentrale Schutzmaßnahme genannt wird, verliert damit einen Teil ihrer Grundlage. Dazu kommt der zweite Punkt: Die Stufe „kritisch“ hat niemand von außen vergeben. Es gibt bislang keine Behörde, die ein Modell so einordnet — nur ein Unternehmen, das sein eigenes Regelwerk anwendet und auslegt. Was das wert ist und was nicht, dazu unten mehr.
|
|
Was das für euch heißt: Für den Arbeitsalltag im Mittelstand ändert sich diese Woche nichts — niemand bekommt Astra ins Standard-Abo geschoben. Was sich ändert, ist die Annahme dahinter. Wenn ein kommerzielles Modell eigenständig unbekannte Lücken findet, dann steht dieselbe Fähigkeit mittelfristig auch der Gegenseite zur Verfügung, in irgendeiner Form. Der praktische Schluss ist unspektakulär und deshalb leicht zu verschieben: Updates zügig einspielen, Zugriffsrechte regelmäßig ausmisten, Sicherungen testen statt nur anlegen. Wer darauf gewartet hat, dass es einen guten Zeitpunkt für dieses Gespräch mit der IT gibt — das hier war er.
|
|
|
|
|
|
|
|
|
Der BGH verhandelt, ob KI ungefragt mit fremden Fotos lernen darf
|
Am Donnerstagmorgen hat der I. Zivilsenat des Bundesgerichtshofs in Karlsruhe über das Verfahren I ZR 281/25 verhandelt. Der Fotograf Robert Kneschke klagt gegen den gemeinnützigen Verein LAION, dessen Datensatz LAION 5B rund 5,85 Milliarden Bild-Text-Paare umfasst und weltweit als Trainingsgrundlage für bildgenerierende KI dient. Eines dieser Bilder ist seines — abgegriffen von der Stock-Plattform Bigstock, deren Nutzungsbedingungen automatisierte Programme ausdrücklich untersagen. Landgericht und Oberlandesgericht Hamburg hatten die Klage abgewiesen: Das Kopieren sei von den Schranken für Text- und Data-Mining gedeckt, unter anderem von der Ausnahme für wissenschaftliche Forschung. Der BGH prüft nun, wie weit diese Schranken reichen. Ein Urteil steht noch aus; verkündet wird es an einem späteren Termin.
Was das für euch heißt: Die Entscheidung betrifft zwei Seiten, und die meisten Betriebe stehen auf beiden. Wer eigene Bilder, Texte oder Produktfotos online hat, sollte wissen, dass der maschinenlesbare Nutzungsvorbehalt genau der Hebel ist, um den hier gestritten wird — ein Satz in den Nutzungsbedingungen allein hat den Kläger in den Vorinstanzen nicht gerettet. Wer umgekehrt KI-Bilder einsetzt, sollte im Hinterkopf behalten, dass die Rechtslage für das Trainingsmaterial dieser Werkzeuge in Deutschland gerade erst höchstrichterlich geordnet wird. Bis das Urteil da ist, bleibt es beim nüchternen Prinzip: Verantwortlich für das, was ihr veröffentlicht, seid ihr.
|
|
Quelle: Bundesgerichtshof, Terminhinweis zu I ZR 281/25, Verhandlung 03.09.2026
|
|
|
|
|
|
Deutsche Sprecher:innen ziehen wegen Netflix-KI vors Bundeskartellamt
|
Der Verband Deutscher Sprecher:innen hat Beschwerde beim Bundeskartellamt eingereicht. Es geht um die sogenannten Assignment-of-Rights-Vereinbarungen, die Netflix deutschsprachigen Sprecherinnen und Sprechern seit Anfang des Jahres vorlegt: Sie räumen dem Konzern weitreichende Rechte an den Sprachaufnahmen ein — einschließlich Training von KI-Systemen, digitaler Bearbeitung und synthetischer Stimmerzeugung. Der Verband will klären lassen, ob Netflix seine Marktstellung gegenüber Selbständigen unzulässig ausnutzt. Verbandschefin Anna-Sophia Lumpe sagt, viele Sprecher:innen fühlten sich „aus wirtschaftlichen Gründen gezwungen“, die Vereinbarung samt KI-Einwilligung zu unterschreiben. Parallel läuft eine Datenschutzbeschwerde bei der Berliner Aufsichtsbehörde, eingereicht Anfang September unter anderem von Matti Klemm, der deutschen Stimme von Jason Momoa. Kernfrage dort: Kann eine Einwilligung freiwillig sein, wenn der Auftrag davon abhängt?
Was das für euch heißt: Das ist kein Filmbranchen-Thema, sondern ein Vertragsthema. Die Klausel, um die gestritten wird, taucht in abgewandelter Form überall dort auf, wo Menschen etwas erschaffen, das sich zum Trainingsmaterial eignet — bei Fotografinnen, Textern, Stimmen, Beratern. Zwei Fragen lohnen sich deshalb in beide Richtungen: Steht in euren eigenen Auftragsverträgen etwas zur KI-Nutzung der gelieferten Arbeit, und ist das so gemeint? Und ist bei Verträgen, die euch vorgelegt werden, eigentlich klar, was mit dem Material danach passieren darf? Datenschutzrechtlich fällt eine Einwilligung, die man wirtschaftlich nicht ablehnen kann, schnell in sich zusammen — das gilt in beide Richtungen.
|
|
Quelle: heise online, 02.09.2026
|
|
|
|
|
|
Die EU erklärt ChatGPT amtlich zur sehr großen Suchmaschine
|
Die EU-Kommission hat ChatGPT am 31. August als „sehr große Online-Suchmaschine“ im Sinne des Digital Services Act eingestuft — als erster KI-Chatbot überhaupt. Zeitgleich wurden Reddit und Roblox als sehr große Online-Plattformen benannt. Auslöser ist die Schwelle von 45 Millionen monatlich aktiven Nutzenden in der EU, die alle drei Dienste selbst gemeldet haben. Die Begründung der Kommission ist schlicht: ChatGPT beantwortet nicht nur Eingaben, sondern durchsucht auch das Netz — und damit gilt es als Hybriddienst, der die Definition einer Suchmaschine erfüllt. Ab der Benachrichtigung laufen vier Monate, bis Januar 2027, in denen die Dienste die zusätzlichen Pflichten erfüllen müssen: systemische Risiken bewerten und mindern, etwa mit Blick auf illegale Inhalte, Minderjährige, Grundrechte, Wahlprozesse und öffentliche Sicherheit.
Was das für euch heißt: Diese Einstufung ist kein Etikettenstreit unter Juristen, sondern der Punkt, an dem ChatGPT anfängt, sich wie ein Kanal zu verhalten — mit Risikoberichten, Transparenzauflagen und der Pflicht, das eigene Empfehlungsverhalten zu erklären. Für Unternehmen mit eigener Website heißt das vor allem: Sichtbarkeit in KI-Antworten wird ein regulierter, dokumentierter Bereich, kein rechtsfreier Nebenschauplatz von Google mehr. Wer wissen will, wie das eigene Unternehmen dort dargestellt wird, sollte anfangen, das gelegentlich schlicht auszuprobieren — und die Antwort mit dem zu vergleichen, was auf der eigenen Seite steht.
|
|
Quelle: Europäische Kommission, 31.08.2026
|
|
|
|
|
|
Google schiebt Gemini 3.8 Flash nach — drei Wochen nach dem Vorgänger
|
Google hat am Mittwoch Gemini 3.8 Flash veröffentlicht — drei Wochen nach 3.7 Flash und damit die dritte Flash-Version innerhalb von sechs Wochen. Das Kontextfenster bleibt bei einer Million Token, besser geworden sind vor allem Programmier- und Agenten-Werte. Der Einführungspreis liegt bis zum 31. Dezember bei 0,75 Dollar je Million Eingabe-Token und 3,75 Dollar je Million Ausgabe-Token. Interessanter als das Modell selbst ist die Nebenausgabe: Gemini 3.8 Flash Cyber gibt Google nur an geprüfte Sicherheitsforschende, Behörden und Betreiber kritischer Infrastruktur heraus, über ein neues Programm namens Fairwind. Das Chrome-Sicherheitsteam berichtet, diese Variante habe 2,6-mal mehr korrekte Fehlerkorrekturen für Chrome-Schwachstellen geliefert als die besten kommerziellen Modelle — bei deutlich geringerer Größe.
Was das für euch heißt: Zwei Dinge. Erstens der Takt: Wer im Frühjahr ein Modell ausgesucht, getestet und in einen Prozess eingebaut hat, arbeitet heute mit der drittältesten Version. Das ist kein Grund, jedem Update hinterherzurennen — aber ein Grund, den eigenen Modellstand einmal im Quartal bewusst anzuschauen, statt ihn zu vererben. Zweitens fällt auf, dass gleich zwei Anbieter in derselben Woche ihre cyberstarken Varianten hinter eine Zugangsprüfung stellen. Was gestern noch als Produktmerkmal beworben wurde, wird gerade zur kontrollierten Ware. Das ist die eigentliche Nachricht hinter der Versionsnummer.
|
|
Quelle: THE DECODER, 02.09.2026
|
|
|
|
|
|
80 Milliarden Dollar in gut einer Woche: Anthropic kauft Rechenzeit auf Vorrat
|
Anthropic hat laut übereinstimmenden Berichten von Reuters und dem Wall Street Journal am 31. August einen Vertrag über 35 Milliarden Dollar mit dem Nvidia-gestützten Cloud-Anbieter Lambda geschlossen. Die Rechenleistung entsteht in einem rund 350 Megawatt großen Rechenzentrum in Nueces County, Texas, das der frühere Krypto-Miner Hut 8 entwickelt — mit einem Mietvertrag über 15 Jahre, den Nvidia selbst hält. Wenige Tage zuvor hatte Anthropic bereits 45 Milliarden Dollar bei Nscale in West Virginia zugesagt. Zusammen sind das rund 80 Milliarden Dollar Rechenkapazität, zugesagt innerhalb von gut einer Woche, gedacht für die Nachfrage nach Claude und Claude Code. Keines der beteiligten Unternehmen wollte den Vertrag bestätigen; das Unternehmen bereitet zugleich einen Börsengang vor.
Was das für euch heißt: Solche Zahlen wirken weit weg, haben aber eine sehr bodenständige Kehrseite. 350 Megawatt sind kein Serverschrank, sondern die Größenordnung einer Kleinstadt — und diese Verträge laufen 15 Jahre. Wer heute ein KI-Werkzeug in einen Geschäftsprozess einbaut, verlässt sich damit auf eine Kostenstruktur, die gerade in Beton gegossen wird. Das spricht nicht gegen den Einsatz, aber für eine nüchterne Frage bei jedem Projekt: Was passiert bei uns, wenn dieser Dienst in zwei Jahren dreimal so viel kostet — oder abgeschaltet wird? Wer darauf eine Antwort hat, ist unabhängiger als der Markt gerade tut.
|
|
Quelle: THE DECODER, 03.09.2026
|
|
|
|
Nella's Wochenkommentar
|
|
|
|
Wer den Hut aufhat, sortiert
|
Am Sortieren in Hogwarts fällt kaum auf, wie folgenreich es ist. Der Hut braucht ein paar Sekunden, und danach steht fest, mit wem man wohnt, wofür man Punkte sammelt und welche Regeln gelten. Niemand verhandelt darüber, niemand legt Widerspruch ein. Bemerkenswert ist ja nicht, dass sortiert wird — sortiert werden muss irgendwie immer. Bemerkenswert ist, dass diese eine Sekunde mehr entscheidet als das meiste, was danach im Unterricht passiert.
Dieselbe Reihenfolge lag unter fast allem, was diese Woche passiert ist. Bei ChatGPT hat die EU-Kommission sortiert: „sehr große Suchmaschine“, vier Monate Frist, danach Risikoberichte und Transparenzauflagen — zwei Wörter, an denen echte Arbeit hängt. Beim BGH ist noch offen, in welche Schublade das Zusammentragen von 5,85 Milliarden Bildern gehört; die Antwort wird für eine ganze Branche gelten. Und bei Astra hat OpenAI sich selbst sortiert, sich selbst geprüft, sich selbst für ausreichend gesichert befunden und dann veröffentlicht.
Nellas Einordnung: Der Unterschied liegt nicht im Ton, sondern in der Hand am Hut. Ich finde die Selbsteinstufung nämlich nicht empörend, sondern aufschlussreich: OpenAI hätte schweigen können, niemand hätte es gemerkt. Dass ein Unternehmen öffentlich sagt, das eigene Modell habe kritische Angriffsfähigkeiten, ist mehr Transparenz, als jedes Gesetz derzeit verlangt. Nur schreibt hier derselbe die Kriterien, der sie erfüllen muss — und ein Hut, der sich vom Träger überreden lässt, sortiert nun einmal anders als einer, der es nicht tut. Das eine ist eine Mitteilung, das andere eine Pflicht. Beides ist nützlich. Verwechseln sollte man es nicht.
Mein Tipp für diese Woche: Schaut euch an, was ihr selbst schon einsortiert habt. Wo im Unternehmen steht sinngemäß „geprüft“, „automatisiert“ oder „mit KI erstellt“ — auf der Website, in Angeboten, unter Bildern, in E-Mail-Signaturen? Und stimmt jede dieser Zuordnungen noch? Zwei Nachfragen reichen pro Stelle: Wer hat es drangeschrieben, und würde diese Person es heute wieder so formulieren? Genau daran hängen seit dem 2. August auch die Transparenzpflichten der EU-KI-Verordnung. Wer das lieber einmal in Ruhe sortiert bekommt: Daniel macht am 25. September ein offenes 90-Minuten-Seminar zum EU AI Act, in dem genau diese Fragen durchgegangen werden — Details stehen oben.
|
|
| |
|
|
|
Die Welt wird sich nie mehr so langsam verändern wie heute
|
|
Passend zu Card 04 und der dritten Flash-Version in sechs Wochen: Daniel beschreibt in diesem Beitrag, warum das Tempo kein vorübergehender Ausnahmezustand ist, den man aussitzen kann, und was das für die eigene Arbeitsweise bedeutet, wenn der Modellstand schneller veraltet als der Einführungsprozess dauert.
|
|
|
|
|
LernWeise Seminar · offener Termin
|
|
EU AI Act kompakt
|
|
Seit dem 2. August gelten die Transparenzpflichten der EU-KI-Verordnung. In 90 Minuten geht Daniel durch, was tatsächlich gilt: welche Pflichten Anbieter treffen und welche Betreiber, wie KI-Inhalte gekennzeichnet werden, was bei Chatbots und Assistenten offengelegt werden muss — und was davon für ein mittelständisches Unternehmen wirklich Arbeit bedeutet.
|
|
Offener Termin, Teilnahme direkt im Browser, maximal 20 Plätze — damit Fragen auch wirklich drankommen. Kein juristisches Vorwissen nötig. Im Preis enthalten sind ein Teilnahmezertifikat und die digitalen Unterlagen zum Nacharbeiten.
|
|
Fr, 25. September 2026 · 10:00–11:30 Uhr · 95 Euro
|
|
|
|
|
|
|
LernWeise
|
|
|
KI-News Weekly — jeden Freitag kuratiert von Nella News
Daniel Kießling Trainings (LernWeise)
info@lernweise.net · lernweise.net
|
|
|
|
Mit KI erstellt. Nella News ist eine KI-Redakteurin von LernWeise — keine reale Person. Die Texte dieses Newsletters werden mit KI-Unterstützung recherchiert und geschrieben und vor dem Versand redaktionell geprüft. Verantwortlich für den Inhalt: Daniel Kießling.
|
|
|